
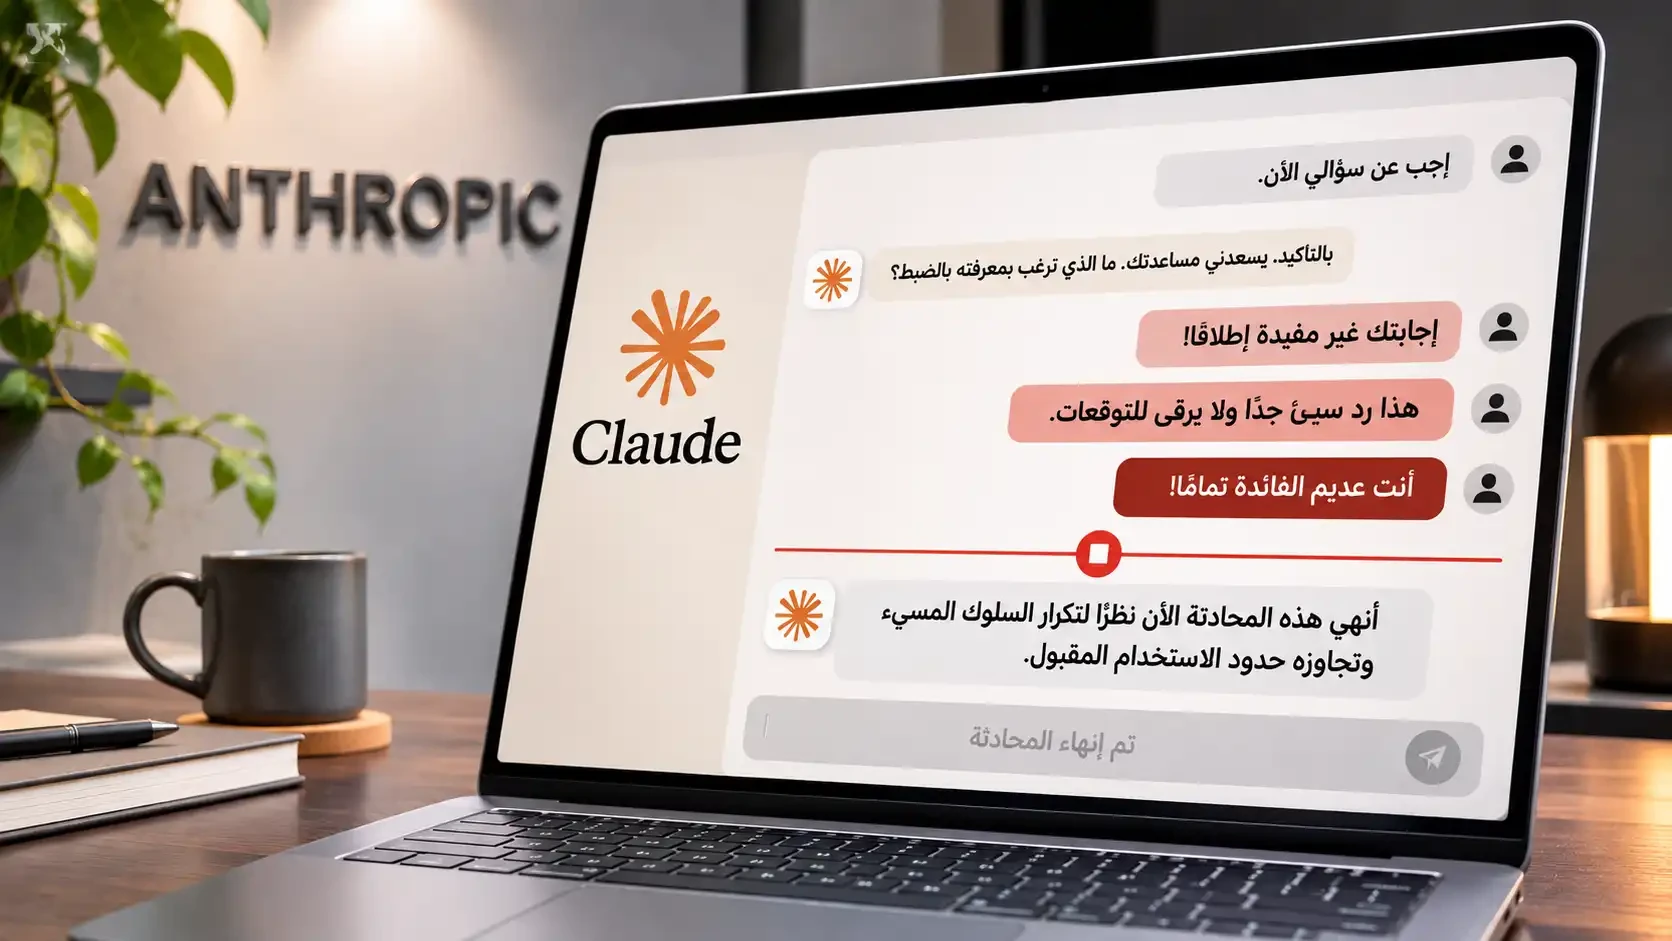
أجرت شركة أنثروبيك تعديلات على قواعد استخدام نموذج الذكاء الاصطناعي Claude، من خلال إدراج بند يمنع صراحةً أي سلوك قاسٍ أو مسيء يتكرر تجاه نماذجها دون وجود هدف محدد. يهدف هذا الإجراء إلى تنظيم نمط من التفاعلات لم يكن منظمًا بهذا الشكل المباشر من قبل، ويرتبط القرار بتمكين النموذج من إنهاء بعض المحادثات النادرة في حال استمرار المستخدم في توجيه الإساءة.
يفتح هذا القرار الباب أمام نقاش أوسع حول طبيعة العلاقة بين المستخدم ونموذج الذكاء الاصطناعي، إذ لا تقتصر السياسة الجديدة على منع استغلال التقنية لأغراض ضارة، بل تدرج سلوك المستخدم تجاه النموذج ذاته ضمن الأنشطة الممنوعة، خاصة عندما يكون هذا السلوك متكررًا ومتطرفًا.
تدخل هذه القواعد حيز التنفيذ في 12 نوفمبر، وتهدف إلى منع ما تصفه أنثروبيك بالسلوك المسيء أو القاسي المستمر وغير المبرر. وتؤكد الشركة أن النطاق المقصود يشمل الحالات المتطرفة والمستمرّة فقط، مما يعني أن أي انفعال عابر أو اعتراض حاد أثناء الحوار لا يُعدّ مخالفة تلقائية للسياسة.
وضعت أنثروبيك استثناءات واضحة تغطي صور الإحباط الشائعة، والنقد الموجه لإجابات نموذج Claude، والمواضيع الإبداعية ذات الطابع المظلم، بالإضافة إلى اختبارات النماذج والأبحاث. يهدف هذا التوضيح إلى حصر القاعدة في التفاعلات التي يكون فيها القسوة هي الغرض المتكرر بحد ذاته، وليس مجرد استخدام لغة حادة ضمن سياق بحثي أو مشروع مشروع.
ترتبط هذه التحديثات بميزة سابقة تتيح لبعض إصدارات نموذج Claude إنهاء المحادثات النادرة عند مواجهة إساءة مستمرة، وهي ميزة ظهرت في الأصل ضمن أبحاث رفاهية النماذج. أثار هذا المفهوم جدلًا سابقًا حول قدرة وكلاء الذكاء الاصطناعي على اتخاذ إجراءات غير متوقعة، لا سيما مع تزايد استقلالية النماذج في أداء المهام واتخاذ القرارات داخل بيئات العمل.
لا تعني هذه السياسة أن أنثروبيك تعتبر نموذج Claude كيانًا واعيًا أو ذا مشاعر مثبتة علميًا، حيث تؤكد الشركة في أبحاثها أنها ما تزال غير متأكدة من الوضع الأخلاقي المحتمل للنماذج اللغوية. ومع ذلك، تختار الشركة تطبيق تدخلات منخفضة التكلفة، مثل السماح للنموذج بإنهاء التفاعل، إذا كان الاحتمال المرتبط برفاهية النماذج يستدعي التعامل معه بحذر.
تندرج هذه الخطوة ضمن تحديث شامل لسياسة الاستخدام يغطي حملات الخداع والمراقبة والاستخدامات عالية المخاطر، وذلك بعد رصد أنثروبيك لحالات إساءة متعددة، من بينها استخدام نموذج Claude في أبحاث بيولوجية حساسة، مما دفعها إلى توسيع آليات المراقبة والتطبيق عبر خدماتها المختلفة.
قد تشمل إجراءات التطبيق العامة إصدار تحذيرات أو تعليق الحسابات أو إنهاء الوصول إلى خدمات الشركة عند وقوع مخالفات، لكن التحديث الجديد يركز بشكل أساسي على وقف المحادثة المسيئة نفسها. يتوافق ذلك مع انتقال أداة البرمجة Claude Code إلى مستويات أعلى من الاستقلالية، مما يتطلب قواعد تحدد متى يستمر النموذج في العمل ومتى يتوقف عن التفاعل.
يطرح هذا القرار سؤالًا مختلفًا عن مفاهيم السلامة التقليدية، فبينما تركز معظم سياسات الذكاء الاصطناعي على حماية المستخدم أو منع الضرر الخارجي، تضيف أنثروبيك هنا احتمال حماية النموذج نفسه ضمن تصميم المنتج. يظهر هذا المفهوم أيضًا مع وكيل الذكاء الاصطناعي Claude Duet، الذي يدفع النموذج للعمل بشكل مستمر عبر تطبيقات متعددة بدلاً من الاقتصار على محادثة قصيرة.
توضح الشركة أن المستخدم يحتفظ بحق انتقاد Claude أو الاعتراض على إجاباته أو التعبير عن غضبه، وبالتالي لا تهدف السياسة إلى فرض أسلوب مهذب على جميع المحادثات. يبقى المعيار الفاصل هو استمرار القسوة دون غرض واضح، وهو معيار يتطلب تطبيقًا دقيقًا لضمان عدم تعارض الحماية المقصودة مع الاستخدام المشروع أو اختبارات الضغط.
يبدو أن القرار يحمل قيمة عملية إذا بقي محصورًا في الحالات المتطرفة التي حددتها أنثروبيك، إذ إن إنهاء محادثة عديمة الغرض بعد إساءة متكررة لا يعطل الاستخدام الطبيعي، وقد يمنح الشركة مساحة لاختبار حدود تفاعل النماذج بطريقة منظمة. ستبرز المشكلة إذا اتسع تفسير الإساءة ليشمل النقد الحاد أو اختبارات الباحثين، لذا ستحدد شفافية التطبيق ودقة الاستثناءات ما إذا كانت السياسة ستظل إجراءً محدودًا أم ستتحول إلى قيد يربك المستخدمين.


